trubidata
./presence

Talks, podcast and publications

Sharing what I learn building data platforms in banking and fintech, across tech communities in LATAM and Spain.

Talk history

Astronomer · The Data FlowcastSep 2026Remoto

Orchestrating data across 30 companies at itti

Kenten Danas me invitó a The Data Flowcast, el podcast de Astronomer, para contar cómo un Centro de Excelencia de Ingeniería de Datos sostiene Airflow para más de 30 empresas, donde la mayoría de quienes lo usan no son data engineers. Fueron unos 20 minutos, grabados por videollamada, sobre cómo hacer que la orquestación sea simple para el resto de la organización.

Show more

Puntos clave

  • Airflow como orquestador, no como motor de procesamiento: unos 300 DAGs en producción.
  • Un framework propio en YAML sobre Airflow, nacido después de que un enfoque tipo DAG Factory generara cuellos de botella en el code review. Más del 80% de los DAGs nuevos ya se crean con él: DAGs en Python, templates Jinja, configs YAML y compilación en CI/CD.
  • Data quality integrada, con una herramienta propia que testea por partición, y operadores custom para dbt, calidad y servicios de AWS como QuickSight.
  • Spec-driven development (un fork de GitHub Spec Kit) para que usuarios de negocio pidan DAGs que agentes generan a partir de templates certificados.
  • Los errores se rutean por Slack al equipo dueño de cada DAG; solo lo profundo escala al equipo central. Próximo paso: PRs disparados por agentes para pipelines que se autocorrigen.
  • Wishlist de Airflow 3: mejores backfills, orquestación por eventos y human-in-the-loop para DAGs de IA generativa.
Docu Viva: Cómo automatizamos toda nuestra documentación
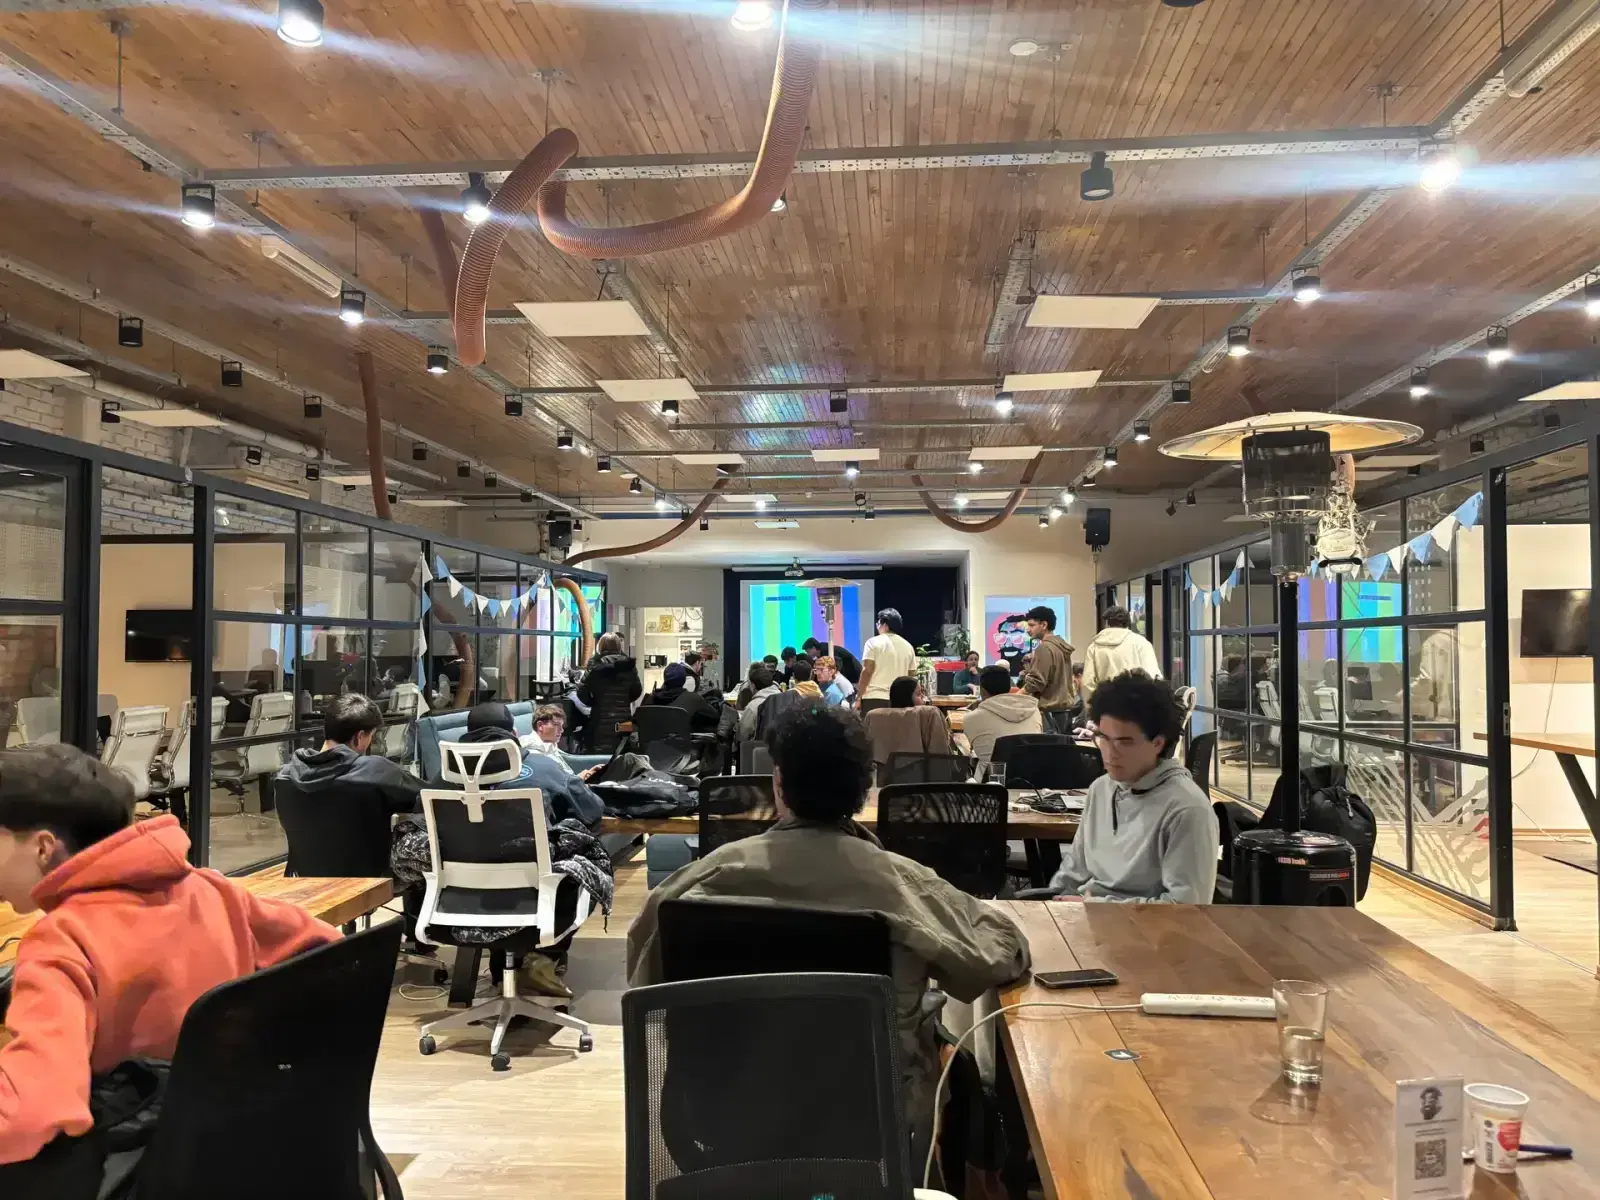
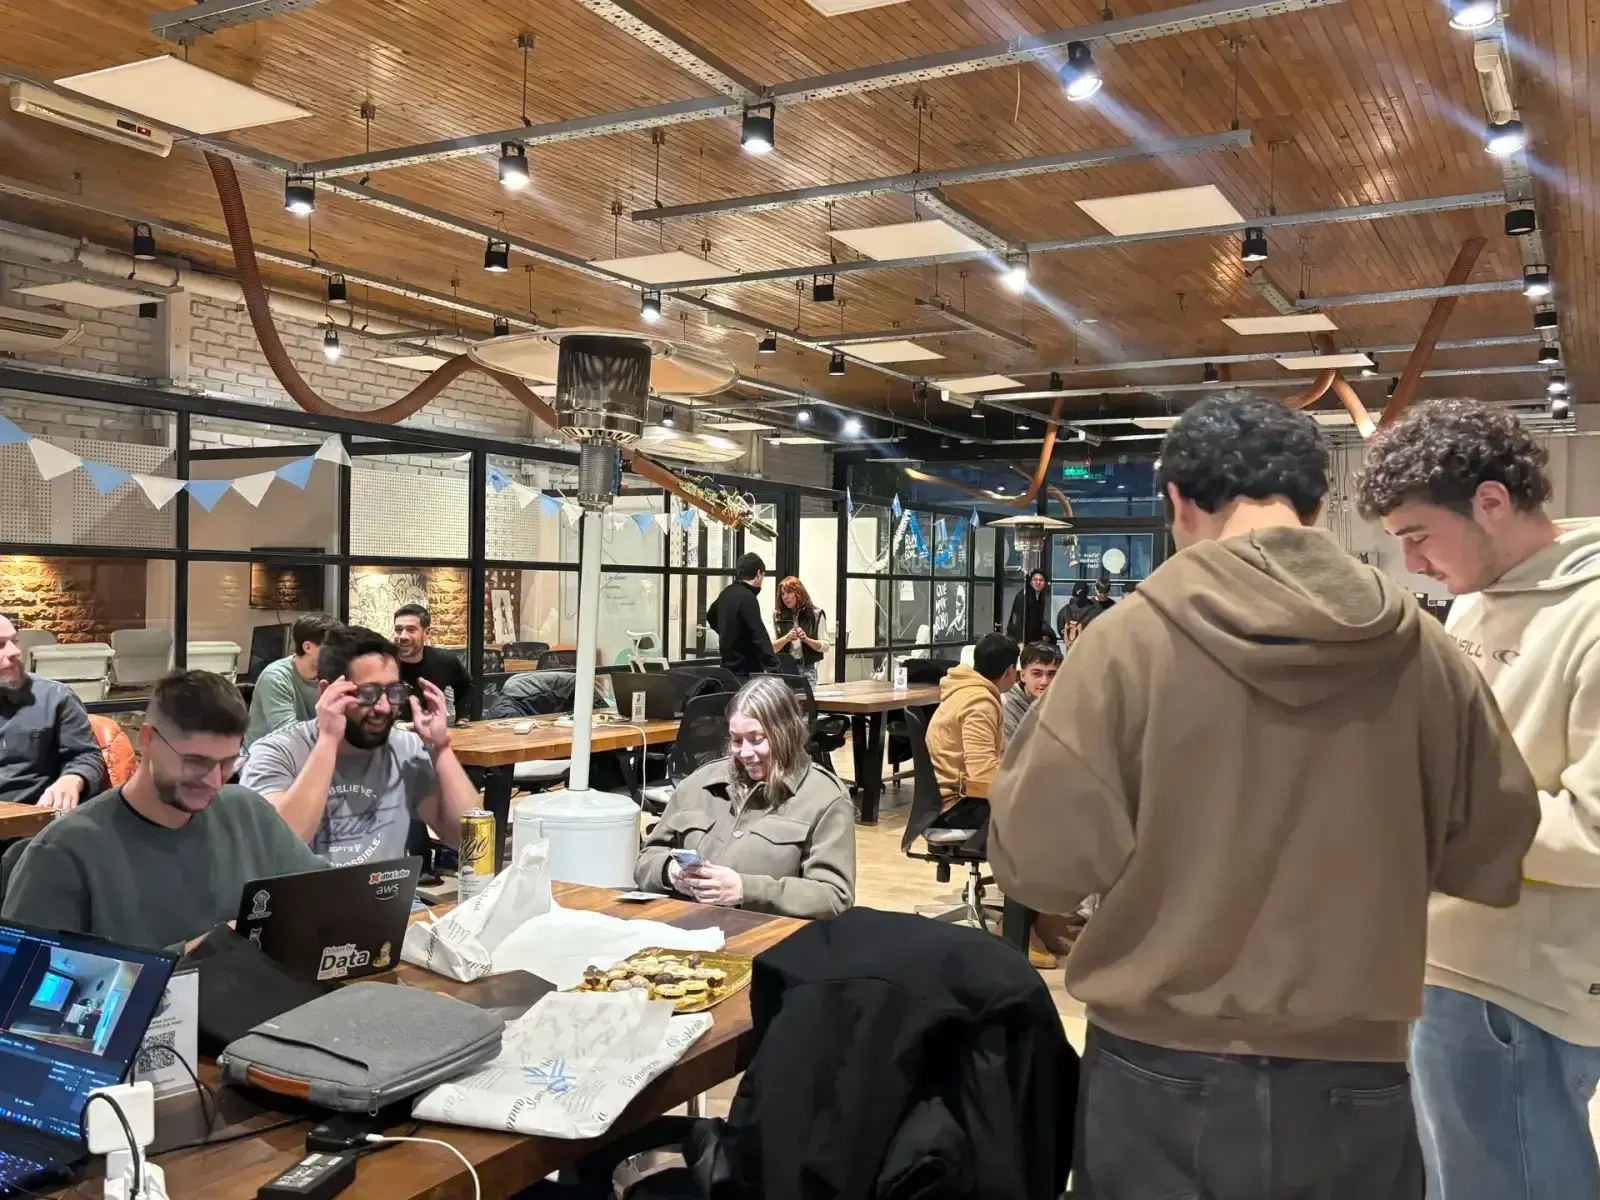
Cursor CommunityJul 2026Campus Olegario, Mendoza, Argentina

Docu Viva: Cómo automatizamos toda nuestra documentación

La documentación que nadie actualiza no es documentación — es arqueología. En este meetup de Cursor Community en Mendoza compartí cómo dejamos de depender de que alguien se acuerde de documentar, y armamos un proceso donde cada cambio de código dispara la revisión de la doc correspondiente: no un LLM reescribiendo desde cero, sino un sistema que detecta qué cambió, propone el diff, y un humano lo aprueba antes de publicar.

Show more

Puntos clave

  • El problema no es la falta de documentación, es que cada equipo la resuelve distinto: sin dueño, sin fuente única, sin definición de cuándo está "hecha".
  • Antes de automatizar, simplificar: plantillas, una única fuente de verdad, doc en el Definition of Done, responsable asignado.
  • Empezar por la mínima versión que ya resuelve el problema — no por el flujo ideal completo.
  • No reinventar la rueda: ya existen proyectos y estándares abiertos (compresión de codebases, grafos de conocimiento, RAG sin embeddings) que resuelven partes del problema mejor de lo que lo haría una solución custom desde cero.
  • Demo en vivo de los 5 loops de Docu Viva: indexación, detección, generación, verificación y distribución — con un humano en el loop entre generación y verificación.
Madrid Fintech Week 2026
Delegación +Partners LatamJun 2026Madrid, España

Madrid Fintech Week 2026

Del 8 al 12 de junio fui a Madrid como parte de una delegación latinoamericana, para una semana de encuentros con bancos y fintechs: una semana con C-Levels de fintechs y bancos de los dos lados del Atlántico. No fui como speaker, fui a escuchar y a conversar.

Show more

Lo que me llevé

  • El gap entre Europa y LATAM no es tecnológico sino regulatorio: PSD2, open finance y MiCA son el piso desde el que Europa construyó, y LATAM está en ese momento ahora.
  • La conversación de IA ya no es adoptarla sino rediseñar equipos, porque la IA tomó parte del trabajo.
  • La tokenización ya tiene marco en Europa (MiCA: stablecoins, activos digitales, pagos programables). En LATAM el camino fue inverso: primero adopción, después regulación.
  • El corredor LATAM-Europa ya tiene tráfico, más del esperado, y se está armando infraestructura.

Tenemos el manual europeo y la velocidad de un mercado que avanza de forma brutal.

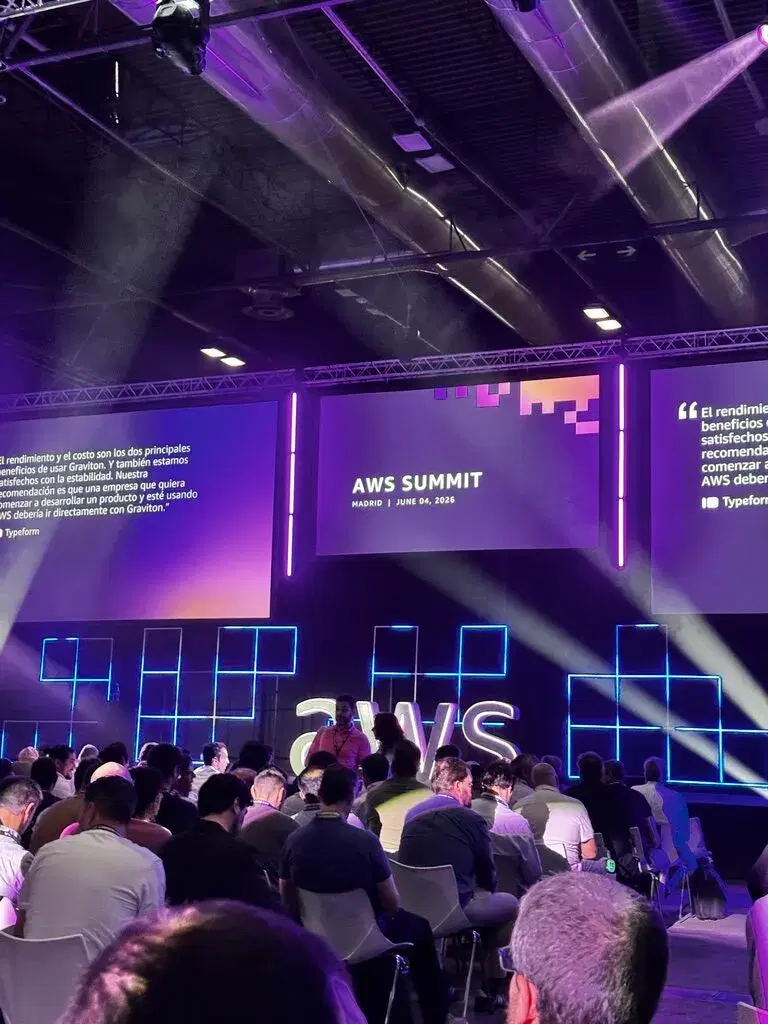
AWS Summit Madrid 2026
AWSJun 2026IFEMA, Madrid, España

AWS Summit Madrid 2026

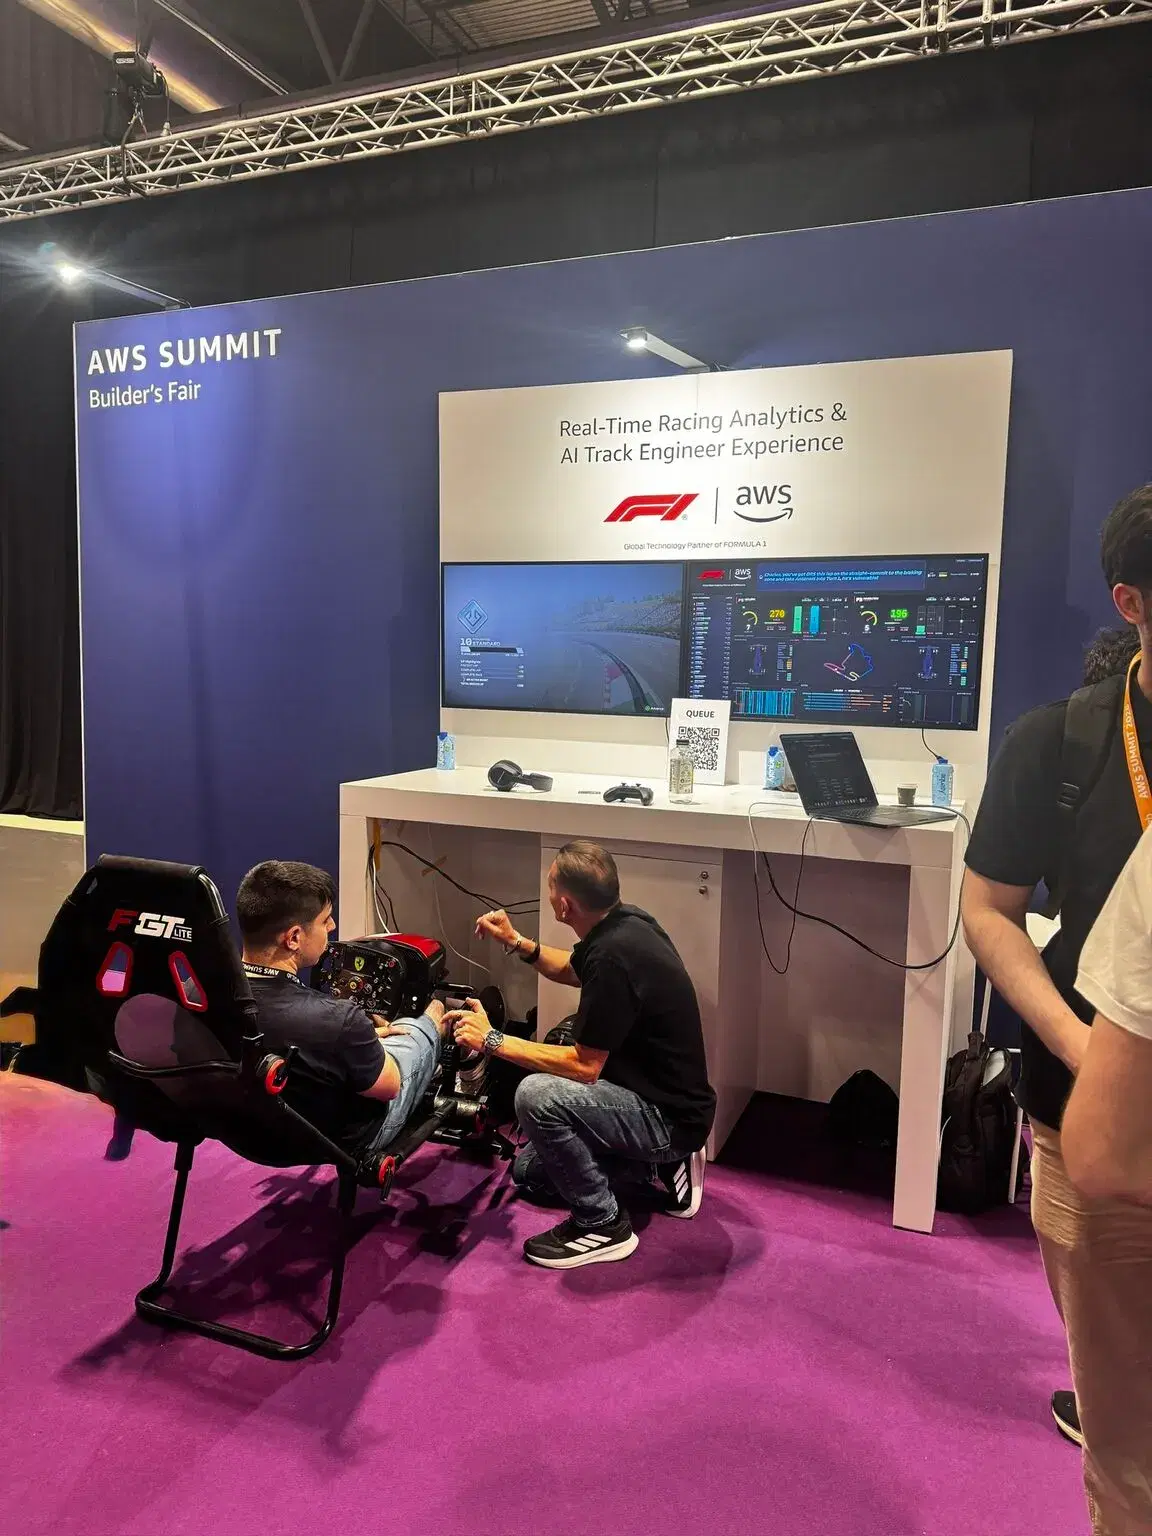
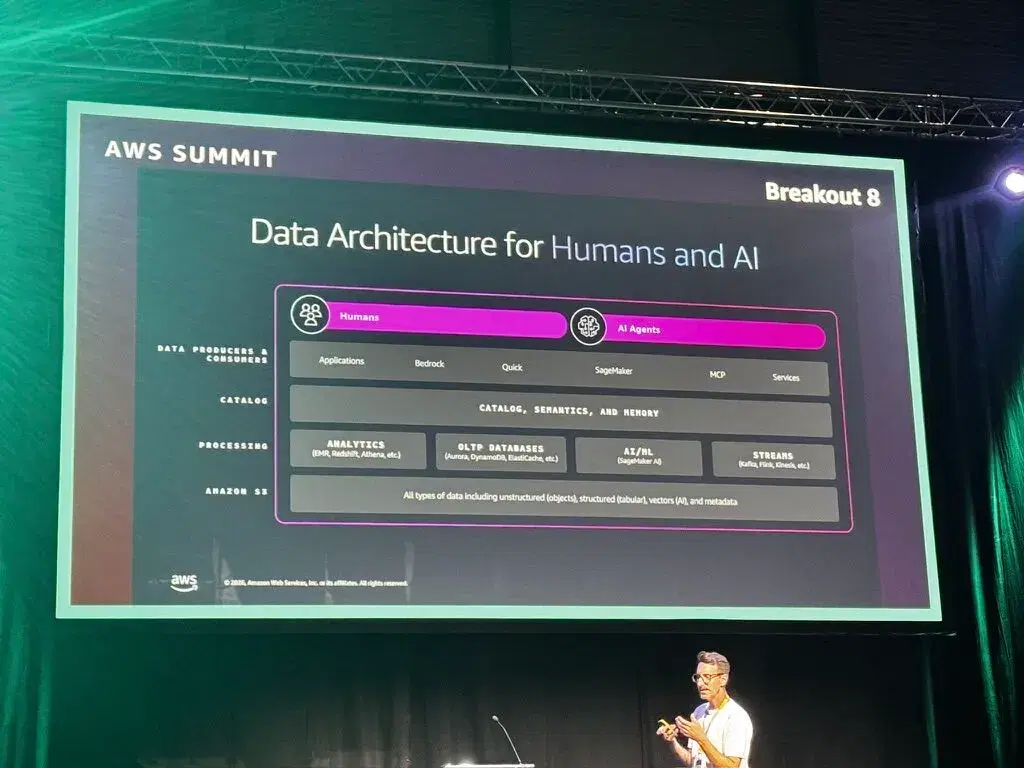
Fui al AWS Summit Madrid, el 4 de junio en IFEMA, como asistente. Pasé el día entre las sesiones de arquitectura de datos para humanos y agentes de IA, el Builder's Fair y conversaciones con equipos que ya tienen agentes en producción, para entender qué tienen en común los que lo lograron.

Show more

Lo que me llevé

  • Cambiar de modelo lleva un sprint; limpiar cinco años de datos, no.
  • AI-Ready es consecuencia de cómo gobernaste los datos, no de un stack.
  • Los equipos con agentes en producción compartían cuatro cosas: inversión previa en gobierno y calidad de datos; una capa semántica entre negocio y datos; un diseño pensado para regulación, auditoría y observabilidad; y una base previa (flujos estandarizados o un chatbot con historial) a la que le sumaron inteligencia, memoria y tools.

Earlier talks

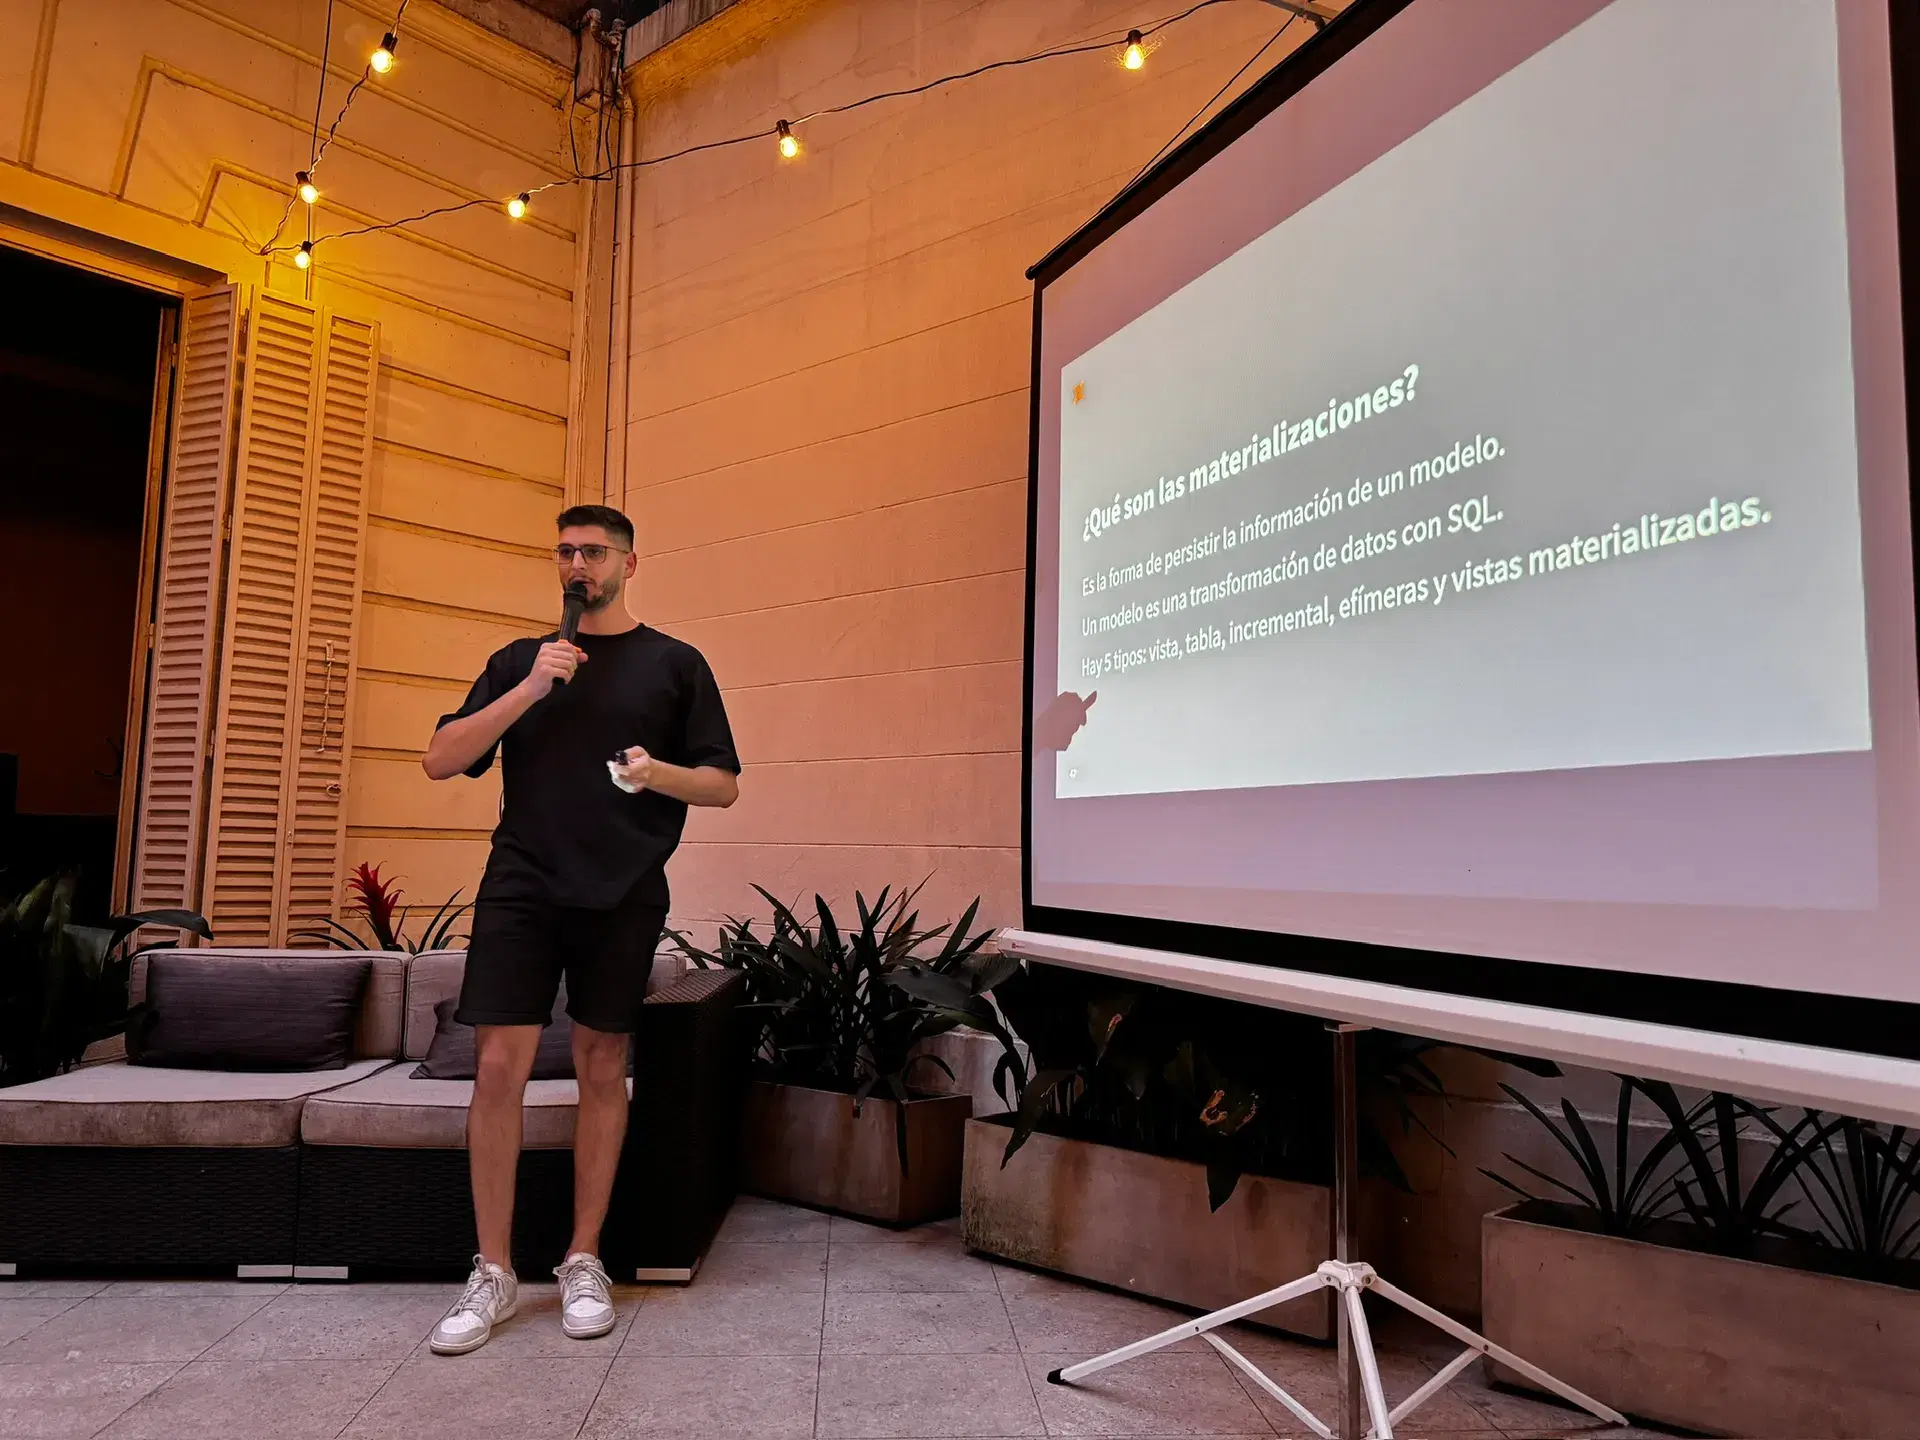
Lo que está bajo el capó de dbt: materializaciones
Featured
dbt LabsDec 2024

Lo que está bajo el capó de dbt: materializaciones

Compartiendo mi experiencia escalando proyectos de dbt en entornos fintech, enfocándome en la gobernanza de datos y la automatización de pruebas de calidad.

El Futuro de los Datos en Tiempo Real
Andes TechMay 2025

El Futuro de los Datos en Tiempo Real

Data Mesh: Democratizando el Acceso a los Datos en AWS
Andes TechOct 2024

Data Mesh: Democratizando el Acceso a los Datos en AWS

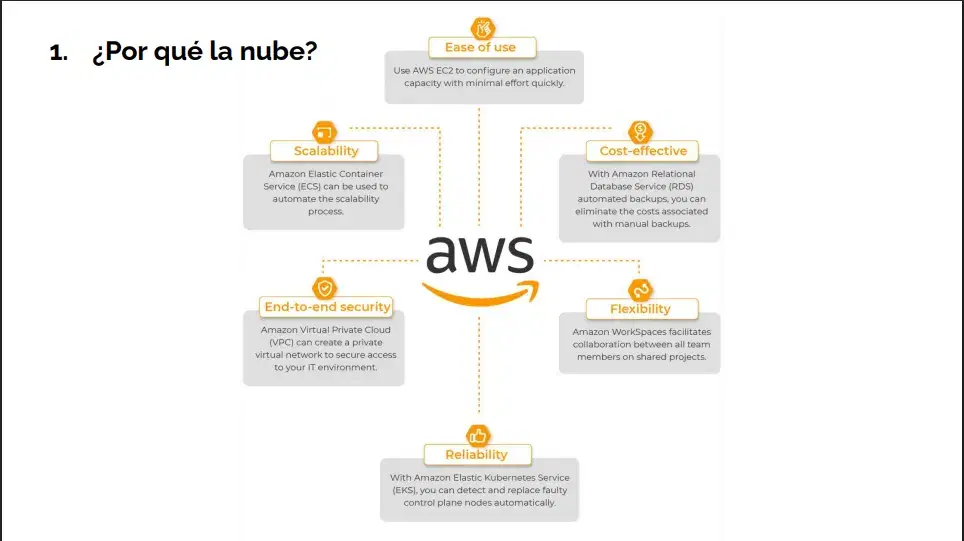
Seguridad y Privacidad de Datos en la Nube
Trubi DataMay 2024

Seguridad y Privacidad de Datos en la Nube

Evolución del Data Center Tradicional al Cloud Computing
Var MdzApr 2024

Evolución del Data Center Tradicional al Cloud Computing

./speaker

Organizing an event?

If you are putting together an event, meetup or corporate training, I'd love to be part of it. Available across LATAM, remote or on-site.

Invite me to your event →